Un agent local peut continuer de travailler pendant que son utilisateur ouvre une autre application. Cette cohabitation pose une question de priorité : quelle tâche doit recevoir les ressources disponibles à cet instant ? Dans ses annonces du 28 octobre, NVIDIA présente un réglage de partage du GPU sur RTX Spark. La nouveauté intéresse autant l’organisation du travail que la puissance affichée dans une fiche technique.
Une priorité à choisir selon la tâche du moment
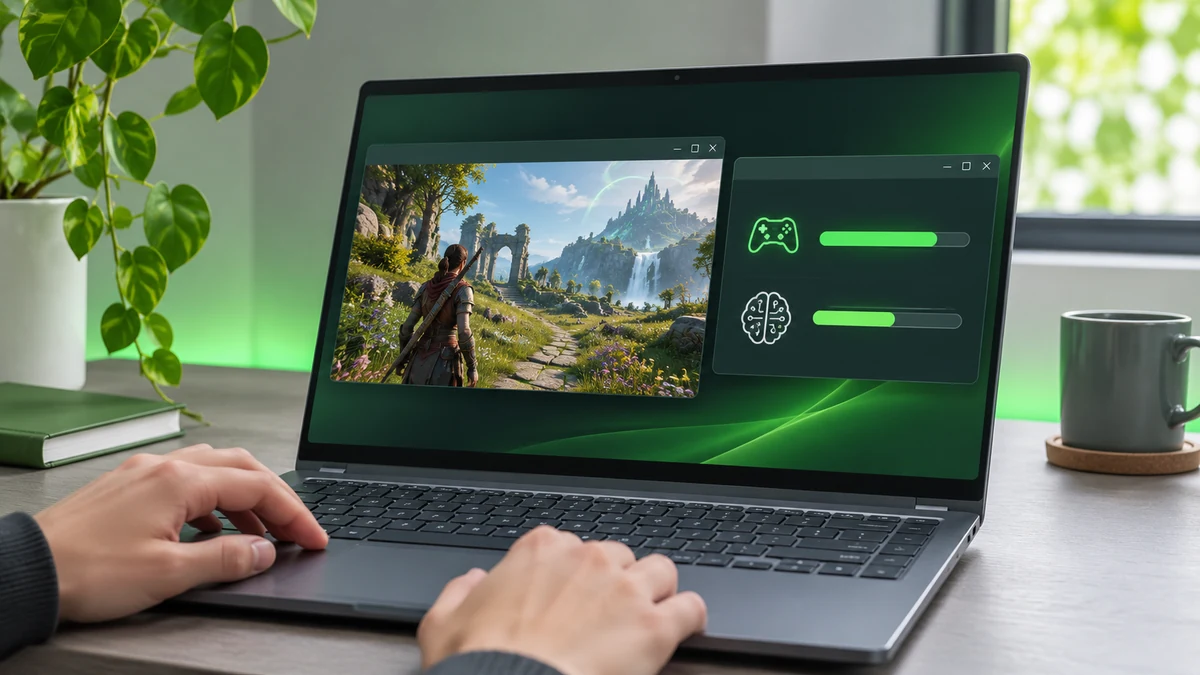
Le billet officiel NVIDIA décrit un contrôle dans NVIDIA App pour répartir les ressources entre l’application au premier plan et l’agent qui travaille en arrière-plan. L’utilisateur peut privilégier son application ou accorder davantage de ressources à l’agent.
NVIDIA indique le chemin System, puis Advanced dans son application, et précise qu’une planification GPU accélérée matériellement doit être activée dans Windows pour cette fonction. L’annonce concerne le contexte RTX Spark présenté dans le billet. Elle ne permet pas de promettre la présence du même réglage sur chaque PC portant une carte graphique de la marque.
Le changement ajoute donc une décision visible. Au lieu de traiter « l’IA locale » comme une seule activité abstraite, il invite à regarder ce qui tourne en même temps et ce que l’on souhaite préserver pendant une tâche importante.
Le besoin change entre attendre un résultat et utiliser le poste
Une personne peut préférer terminer rapidement une analyse lorsqu’elle n’utilise pas son ordinateur pour autre chose. À un autre moment, elle peut avoir besoin d’une application confortable pour présenter un document ou travailler sur un projet. Ces situations n’appellent pas forcément la même priorité.
Pour comprendre l’intérêt du réglage, l’équipe peut préparer deux scénarios représentatifs. Dans le premier, l’agent exécute une tâche connue avec peu d’activité humaine sur le poste. Dans le second, la même tâche accompagne l’usage habituel de l’application principale. On observe alors le résultat dans un cadre qui ressemble au travail réel.
Il faut conserver un objectif précis pour l’essai. « Le poste reste-t-il agréable pour cette tâche ? » et « combien de temps attend-on le résultat ? » sont deux questions différentes. Les réponses peuvent conduire à des choix distincts selon le moment de la journée.
Notre article sur les usages de Nemotron 3.5 Transcribe fournit un exemple de travail local à examiner avec son contexte. La disponibilité d’un modèle ne dit pas comment l’ensemble des applications du poste se comportera lorsqu’elles sont utilisées simultanément.
Comparer sans changer toute la configuration
Un test devient plus clair lorsque l’on garde les mêmes données d’essai et la même tâche principale. Si le modèle, le document, l’application et plusieurs réglages changent en même temps, il devient difficile d’attribuer une différence à la priorité GPU choisie.
Le compte rendu peut rester court : contexte matériel, tâche de l’agent, application utilisée et observations. Les données employées doivent être adaptées aux règles de l’organisation. Un essai de performances n’a pas besoin d’exposer des documents confidentiels pour produire un premier repère.
On peut également demander à l’utilisateur de décrire le problème qu’il cherche à réduire. Un délai de résultat, une gêne pendant une manipulation et une erreur de traitement ne se résolvent pas nécessairement de la même façon. Le réglage de ressources doit être relié à ce diagnostic.
Garder un contrôle sur le résultat de l’agent
Accélérer une tâche ne garantit pas que sa réponse est juste. Le contrôle du contenu reste nécessaire, avec une méthode adaptée à l’usage. Une transcription peut demander une vérification des noms et des chiffres ; une analyse documentaire peut demander un rapprochement avec les sources.
Notre dossier sur FLUX 3 Image Klein sur du matériel local rappelle qu’un seuil matériel et un résultat utile sont deux sujets à distinguer. Les ressources disponibles aident à comprendre ce qui peut fonctionner, mais elles ne valident pas automatiquement la qualité de chaque production.
Le même raisonnement s’applique au partage annoncé par NVIDIA. Un agent plus rapide doit encore produire le bon résultat, tandis que l’application principale doit rester adaptée au travail attendu. Le meilleur compromis dépendra des usages observés, et non d’un réglage présenté comme idéal pour tout le monde.
Un réglage à examiner dans un poste réellement utilisé
Cette nouveauté rend plus concrète la cohabitation des agents locaux et des applications ordinaires. Pour l’évaluer, un premier essai limité sur une configuration compatible donnera un repère plus utile qu’une comparaison générale de puissance.
Le bilan pourra préciser les situations où l’on privilégie l’utilisateur et celles où l’on peut laisser davantage de ressources au traitement. Avec ces repères, le partage du GPU devient une décision de travail expliquée, que l’on peut revoir lorsque les tâches, les outils ou les besoins de l’équipe évoluent.

Je suis Romain, rédacteur passionné par tout ce qui touche au high-tech, à la crypto, et à l’innovation. Diplômé d’une école de marketing à Paris, je mets ma plume au service des dernières tendances et avancées technologiques.