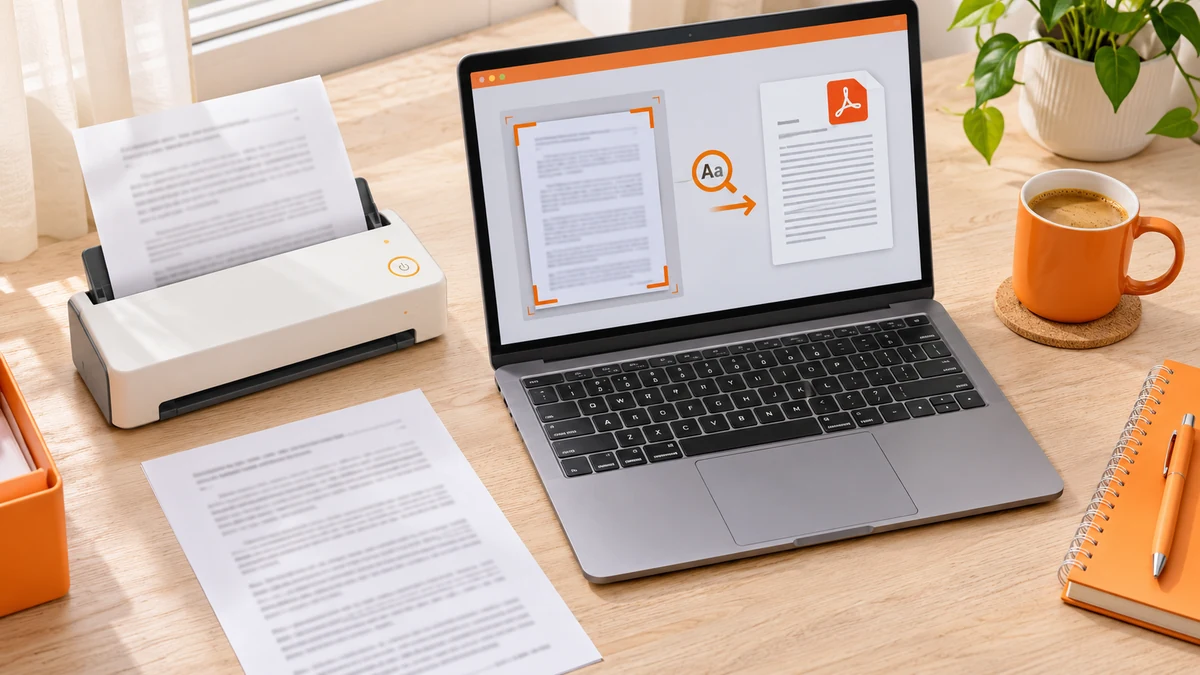
Le mot apparaît clairement sur la page, mais la recherche du lecteur PDF ne le trouve pas. Le document peut contenir une image de texte plutôt qu’un texte directement exploitable. Avant de changer d’application, un petit diagnostic permet de comprendre le PDF numérisé reçu et de choisir une méthode adaptée pour chercher, sélectionner ou réutiliser ses informations.
Comparer ce que l’on voit et ce que l’on peut sélectionner
Un document lisible à l’écran ne se comporte pas toujours comme un document contenant du texte sélectionnable. Pour commencer, on peut essayer de sélectionner quelques mots connus, puis rechercher une expression courte présente sur une page. Le résultat donne un premier indice sur la nature du contenu.
Il faut rester prudent dans l’interprétation. Une recherche infructueuse peut aussi venir de la formulation saisie ou d’une autre particularité du document. L’objectif est de réunir quelques observations avant de choisir une intervention, pas de conclure à partir d’un seul essai.
La documentation Adobe sur la reconnaissance de texte explique que la numérisation peut produire des données d’image sans texte consultable. La reconnaissance optique de caractères, ou OCR, permet de convertir le texte de ces images en contenu sélectionnable et recherchable.
Garder l’original avant de préparer une copie de travail
Lorsqu’un traitement est envisagé, conserver le document reçu comme référence facilite les comparaisons. Une copie distincte peut servir aux essais. On sait ainsi quel fichier représente la source et lequel contient le résultat du traitement choisi.
Cette distinction est utile pour une équipe qui échange plusieurs versions. Le nom du document et sa place dans le dossier doivent permettre de retrouver l’original sans demander à chacun ce qu’il a modifié. Une convention simple peut suffire, avec une date ou une indication de traitement compréhensible.
Notre article sur les modifications de fichiers dans une conversation avec Gemini complète la réflexion. Une transformation pratique ne dispense pas de savoir quelle version est utilisée et quelles limites s’appliquent au format concerné.
Tester quelques éléments qui comptent vraiment
Après un traitement OCR réalisé avec un outil approprié et autorisé, on peut vérifier des passages représentatifs. Une recherche sur un titre facile ne suffit pas si le document sert à exploiter des références, des dates ou des montants. Le contrôle doit suivre l’usage prévu.
Pour un catalogue, une lettre confondue avec un chiffre peut rendre une référence difficile à retrouver. Pour un tableau, une valeur mal associée à sa ligne peut produire une mauvaise interprétation. Les zones importantes méritent donc une comparaison avec l’image de la page d’origine.
La fiche Adobe sur la correction du texte reconnu présente des fonctions de révision des mots incertains. La possibilité de corriger rappelle une limite essentielle : un résultat de reconnaissance doit être vérifié lorsqu’il sert à une décision ou à une reprise de données.
Ne pas confondre recherche possible et données validées
Une fois les mots retrouvés, le document paraît souvent plus facile à utiliser. Cela ne prouve pas que chaque élément a été reconnu correctement. La recherche et la vérification du contenu répondent à deux besoins différents, même lorsqu’elles utilisent le même fichier.
Le compte rendu d’un traitement peut donc préciser ce qui a été testé. Par exemple, les titres et quelques références ont été contrôlés, mais le tableau complet n’a pas encore fait l’objet d’une comparaison. Cette formulation donne au prochain utilisateur une limite explicite plutôt qu’une assurance générale.
Notre dossier sur les sources affichées dans les cellules générées par IA rejoint ce principe : rendre une information plus accessible aide au contrôle, mais ne remplace pas le contrôle lui-même.
Choisir ensuite la bonne façon de travailler
Si le besoin consiste seulement à retrouver un passage, un PDF consultable peut suffire. Si l’objectif est de construire un tableau de données ou de reprendre un document entier, le projet demande des vérifications supplémentaires sur la structure et le résultat attendu. Ces deux usages ne devraient pas recevoir la même promesse.
En pratique, le bon départ est modeste : identifier le type de contenu, conserver la source et tester un échantillon pertinent. Le problème d’une recherche vide devient alors plus clair. On ne cherche plus seulement un lecteur PDF qui semble fonctionner, mais un fichier dont on comprend le contenu et les limites pour la tâche à accomplir.

Je suis Romain, rédacteur passionné par tout ce qui touche au high-tech, à la crypto, et à l’innovation. Diplômé d’une école de marketing à Paris, je mets ma plume au service des dernières tendances et avancées technologiques.