Un outil d’extraction documentaire peut transformer des pages en champs prêts à alimenter un tableau ou un logiciel métier. La présentation est souvent convaincante : dates, références et montants apparaissent dans des cases ordonnées. Pourtant, une valeur plausible peut avoir été associée au mauvais passage, et un champ vide peut signaler une ambiguïté importante. Pour une entreprise, l’enjeu n’est donc pas seulement de remplir les cases plus vite. Il faut pouvoir retrouver l’origine de chaque valeur et décider comment traiter les informations incertaines.
En bref : conserver le passage source, vérifier la signification du champ et prévoir les exceptions permet de contrôler une extraction avant son utilisation métier.
Définir les champs avant de demander leur extraction
Un champ appelé « date » est insuffisant si le document contient une date d’émission, une échéance et une date de livraison. La définition doit indiquer l’information recherchée et les cas dans lesquels elle peut manquer. Cette précision sert à la configuration de l’outil et à la vérification humaine. Elle évite de juger une extraction sur son apparence : une date au bon format n’est pas nécessairement la date dont le processus de l’entreprise a besoin.
Le même principe concerne les identifiants et les noms. Une référence peut contenir des zéros initiaux ou des signes qui ont un sens dans le système de destination. Une transformation automatique doit être explicitée avant l’import. L’équipe peut préparer un dictionnaire court avec la définition, le format attendu, les variantes connues et la règle en cas d’absence. Ce document n’a pas besoin de décrire tous les fichiers possibles pour être utile : il rend déjà les désaccords visibles sur les cas courants.
Demander une origine consultable pour la valeur
Certaines réponses techniques d’extraction associent une entité à un passage du texte, à une page ou à un emplacement dans le document, et peuvent fournir un score de confiance. Ces éléments facilitent la vérification lorsqu’ils sont disponibles dans le service choisi. Il faut regarder si l’interface utilisée par l’équipe les expose réellement. Une référence conservée dans une réponse technique mais absente du parcours de validation aide peu le salarié chargé d’examiner une valeur douteuse.
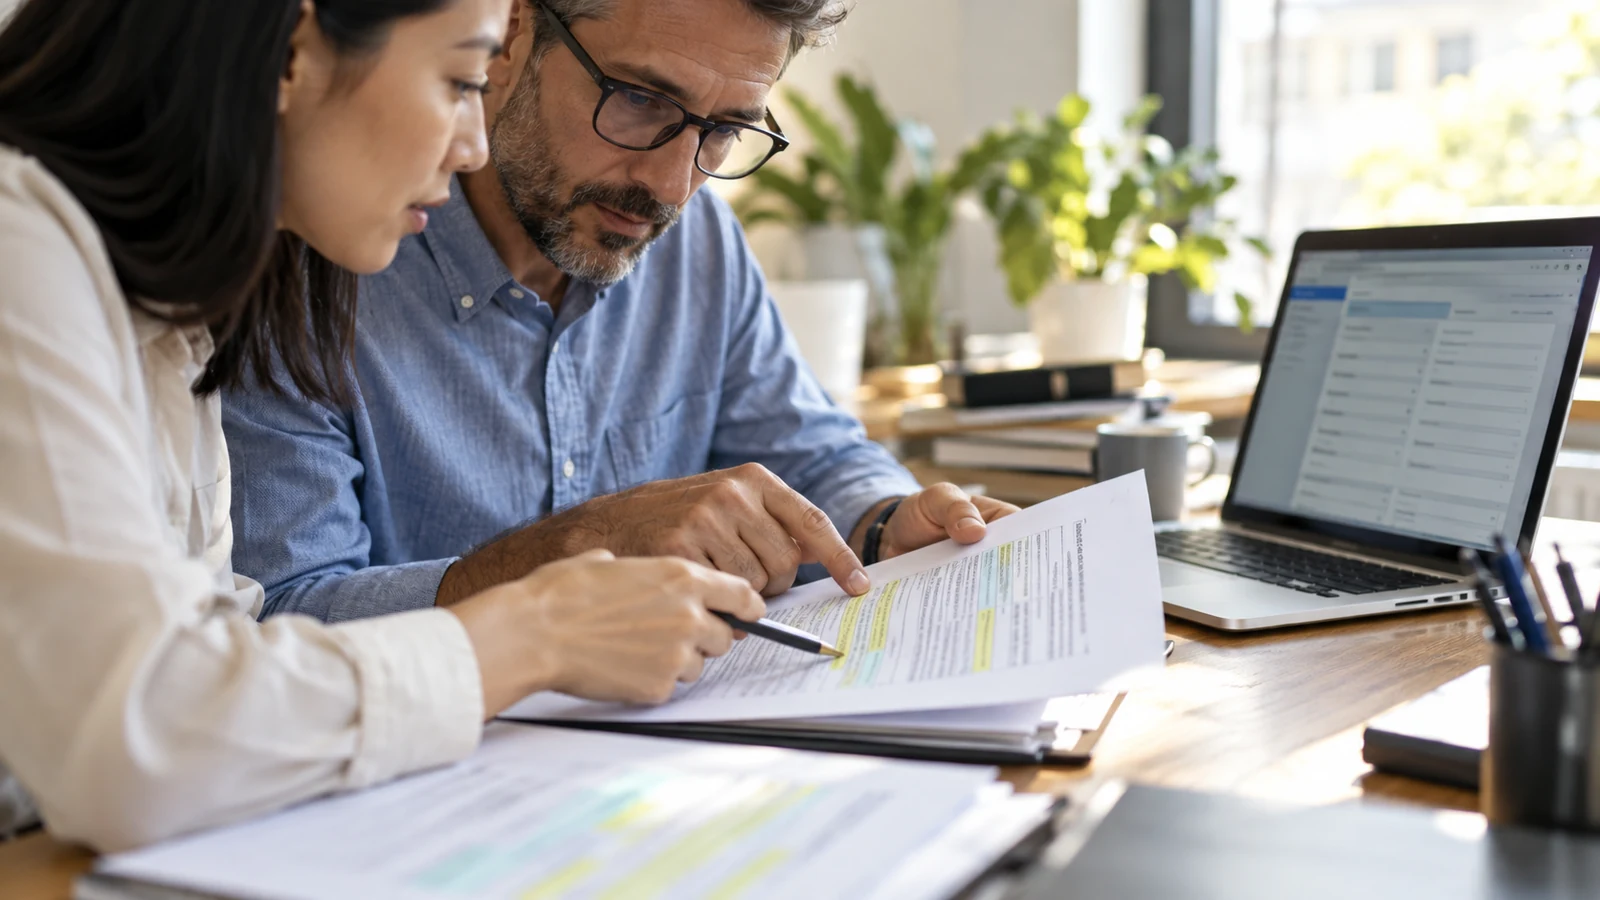
Le passage source permet de distinguer plusieurs erreurs : lecture incorrecte, sélection de la mauvaise occurrence ou interprétation inadéquate du champ. Dans un exemple fictif, deux dates proches peuvent être correctement reconnues, mais affectées aux mauvaises colonnes. La correction ne consiste alors pas à améliorer les caractères reconnus ; elle concerne la règle de sélection. Sans accès au document, ces causes restent difficiles à séparer et l’équipe risque de corriger les résultats sans comprendre pourquoi l’erreur se reproduit.
Ne pas confondre confiance et validation métier
Un score fourni par l’outil renseigne sur un mécanisme du service, avec une signification propre à son modèle. Il ne prouve pas que le résultat satisfait la règle métier de l’entreprise. Une valeur peut être reconnue avec assurance tout en appartenant à une autre section. Le seuil de revue doit donc être testé sur des documents représentatifs. Il faut aussi conserver des contrôles indépendants : champs obligatoires, formats, cohérence entre informations et correspondance avec un référentiel lorsqu’il existe.
Les documents difficiles doivent faire partie de l’essai : pages inclinées, mises en page nouvelles, tableaux coupés ou annotations. L’équipe peut constituer un petit jeu de cas dont les réponses attendues sont connues. Elle mesure les erreurs par champ et par type de document, plutôt que de résumer toute la qualité dans un pourcentage global. Cette lecture indique où une validation reste nécessaire et quelles familles de documents peuvent suivre un circuit plus simple sans masquer les exceptions les plus coûteuses.
Un champ extrait peut ensuite être chargé dans un logiciel. Cette étape rejoint les formats à préserver lors d’un import de données.
Organiser le traitement des exceptions jusqu’au bout
Une extraction incertaine doit aboutir à une action définie : revue, demande d’un meilleur document ou suspension de l’import. Le logiciel ne doit pas remplacer silencieusement une valeur manquante par une supposition simplement pour compléter une ligne. Il faut également savoir qui corrige, où la correction est conservée et comment elle se propage au système de destination. Sinon, deux versions peuvent coexister : la valeur corrigée dans l’outil documentaire et la valeur initiale encore utilisée dans le processus métier.
La décision d’achat doit porter sur ce circuit complet. Le fournisseur peut montrer une extraction réussie ; l’entreprise doit aussi demander une extraction ambiguë et sa résolution. La possibilité de retrouver le passage, de documenter le choix et d’éviter une nouvelle erreur compte autant que la rapidité de traitement. Une extraction utile ne livre pas seulement des champs remplis. Elle fournit des données dont le sens et l’origine restent vérifiables au moment où elles commencent à guider une action de l’entreprise.

Je suis Romain, rédacteur passionné par tout ce qui touche au high-tech, à la crypto, et à l’innovation. Diplômé d’une école de marketing à Paris, je mets ma plume au service des dernières tendances et avancées technologiques.