Un modèle plus petit peut être intéressant s’il correspond précisément au travail demandé. Liquid AI a présenté LFM3 le 27 octobre comme une famille multimodale destinée à cette spécialisation, avec des versions de la classe des deux milliards de paramètres. Texte, vision et audio partagent une base commune, tandis que les poids peuvent être téléchargés et adaptés selon les conditions du projet.
L’annonce nourrit l’intérêt pour l’IA locale. Elle ne signifie pas qu’un petit modèle devient automatiquement un assistant universel fiable, ni que le téléchargement suffit à faire fonctionner une application complète.
Une famille à choisir selon les entrées et les sorties attendues
Dans son billet de lancement, Liquid AI décrit six modèles issus de la même base, avec des variantes pour le texte, la vision, l’audio, le multimodal et des tâches de décision. Le modèle texte LFM3-1.7B est notamment présenté avec une fenêtre de contexte de 256 000 tokens. L’entreprise annonce environ 1 Go pour ses poids en précision quatre bits. Cette taille ne représente pas toute la mémoire nécessaire à une application en fonctionnement.
Le choix dépend d’abord de la tâche. Lire un texte, analyser une image et produire une réponse vocale ne demandent pas les mêmes composants. Une famille commune facilite la compréhension de l’offre sans rendre toutes les variantes interchangeables.
Les résultats de performance présentés par le fournisseur doivent aussi rester attribués à ses mesures. Une bonne place dans un test ne garantit pas le même niveau de réponse sur les documents, la langue et les outils d’une entreprise donnée.
Le local donne un autre contrôle, avec d’autres responsabilités
Faire tourner un modèle sur une machine proche de l’usage peut éviter certains échanges systématiques avec un service distant. Mais il faut regarder l’application complète. Un modèle local peut être entouré d’outils qui contactent le réseau, consultent une API ou envoient des informations ailleurs.
Il est donc préférable de vérifier le trajet des données plutôt que de s’arrêter à l’étiquette « local ». Quels fichiers sont lus ? Quels outils sont disponibles ? Que conserve l’application ? Ces questions déterminent le fonctionnement réel et les droits à encadrer.
Notre article sur les comptes de service et le propriétaire d’une automatisation rappelle un point utile dès qu’un modèle agit avec des outils. Une tâche exécutée sans connexion humaine permanente doit tout de même avoir un responsable, des accès définis et un suivi compréhensible.
Une spécialisation doit être mesurée sur des exemples difficiles
Le premier test ne devrait pas uniquement contenir des cas faciles et bien présentés. Une application utile doit aussi rencontrer des demandes ambiguës, des informations absentes et des entrées inhabituelles. Le résultat attendu peut parfois être une demande de précision ou un refus de conclure.
Pour une tâche documentaire, une équipe peut préparer un petit ensemble de questions avec les réponses de référence et les passages qui les justifient. Elle observe ensuite les erreurs, les oublis et les affirmations qui dépassent les documents. Ce contrôle donne davantage d’information qu’une démonstration où l’on ne regarde que les réponses fluides.
L’adaptation d’un modèle demande aussi des données autorisées et représentatives. Ajouter des exemples ne garantit pas de corriger tous les problèmes. Il faut vérifier que les améliorations sur certains cas ne dégradent pas d’autres comportements importants pour l’usage.
Le suivi doit rester identique lorsque l’on change une version du modèle ou un réglage. Sans ce repère, une impression de progrès peut venir simplement d’un ensemble de questions plus favorable.
Le matériel se choisit après le besoin
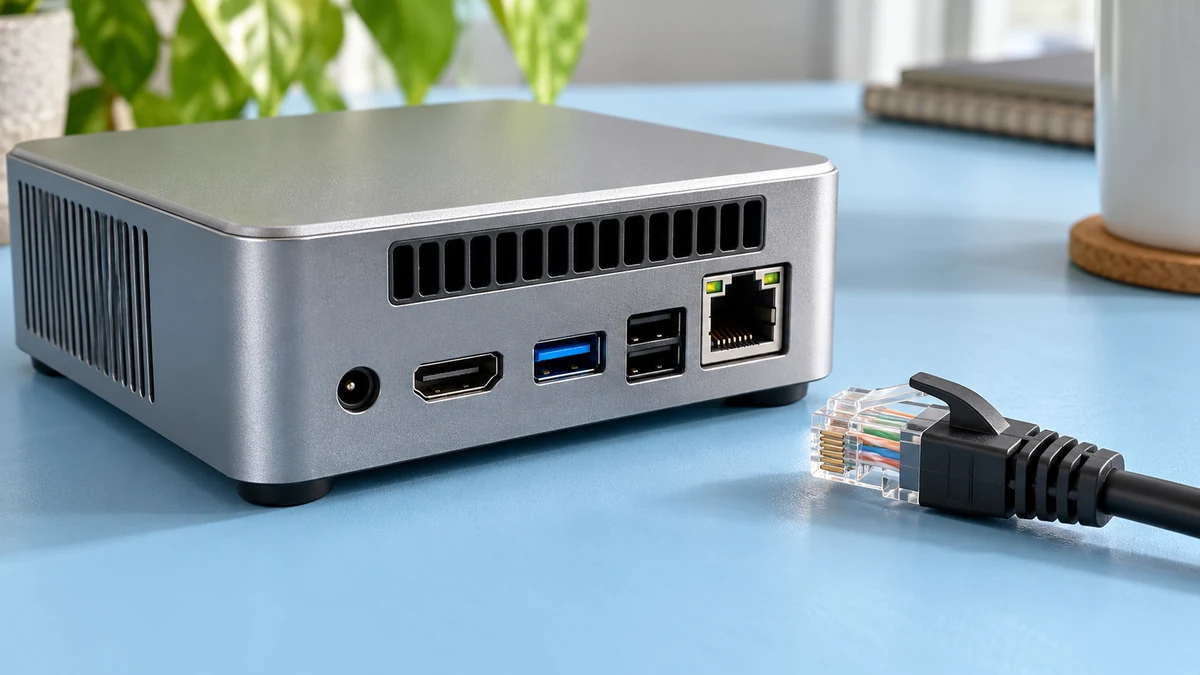
Une faible taille de poids peut rendre une expérimentation plus accessible. Elle ne suffit pas à prédire la vitesse, la consommation ou la quantité de mémoire disponible pendant une longue conversation. Le contexte traité et les autres composants de l’application entrent dans le calcul.
Il est donc utile de commencer avec le matériel déjà disponible, dans un périmètre limité, puis de mesurer les contraintes rencontrées. Cette démarche évite d’acheter un équipement sur une promesse générale avant de savoir quel problème doit réellement être résolu.
Le coût comprend enfin le temps de configuration, la validation et la maintenance. Un modèle téléchargeable ne rend pas ces étapes gratuites. Une équipe doit pouvoir mettre à jour son environnement et retrouver la cause d’un changement de comportement.
LFM3 apporte de nouvelles options à ce travail de spécialisation. Le progrès le plus intéressant sera celui d’un usage précis qui fonctionne avec des limites connues. C’est à cette échelle qu’un petit modèle local peut devenir un outil utile, plutôt qu’une simple fiche technique prometteuse.

Je suis Romain, rédacteur passionné par tout ce qui touche au high-tech, à la crypto, et à l’innovation. Diplômé d’une école de marketing à Paris, je mets ma plume au service des dernières tendances et avancées technologiques.